«Вернём всё быстро» — обещание, которое трудно проверить. RPO и RTO превращают его в два конкретных требования: до какого момента вернуть данные и к какому времени возобновить работу.
Фото: petradr / Unsplash. Unsplash License.
В учебном примере интернет-магазин перестал принимать заказы в 14:20. Команда вернула базу к состоянию на 13:50, а приём заказов возобновила в 16:05. Между точкой восстановленных данных и аварией — 30 минут. Между остановкой и возвращением сервиса — 1 час 45 минут. Это разные потери, и уменьшать их приходится разными средствами.
RPO описывает допустимую потерю данных
Recovery Point Objective — требование к точке времени, до которой нужно вернуть данные после сбоя. Так RPO определяет NIST. В практическом разговоре его обычно выражают как допустимое окно потери: например, не более 30 минут изменений.
Если магазин согласовал RPO 15 минут, возврат к состоянию на 13:50 после аварии в 14:20 не уложился в цель. Если согласовал час — уложился. При этом сначала нужно убедиться, что точка действительно пригодна: копия читается, база открывается, связанные данные согласованы.
RPO измеряется временем, но последствия зависят от содержимого этого окна. Потерять десять минут изменений в личном черновике и десять минут подтверждённых заказов — разные ситуации. Поэтому цель выбирает владелец процесса вместе с технической командой, а не только администратор программы копирования.
RTO описывает допустимое время восстановления
Recovery Time Objective — целевое допустимое время возвращения системы к работе. В определении NIST оно связано с влиянием восстановления на задачи организации. AWS формулирует RTO как максимально допустимую задержку между прерыванием и восстановлением сервиса.
Для магазина из примера измеренный простой составил 1 час 45 минут. При цели два часа тест проходит по времени. Но только если к 16:05 пользователь действительно смог оформить заказ и получить ожидаемый результат. Работающая виртуальная машина сама по себе ещё не означает, что магазин принимает оплату и сохраняет покупки.
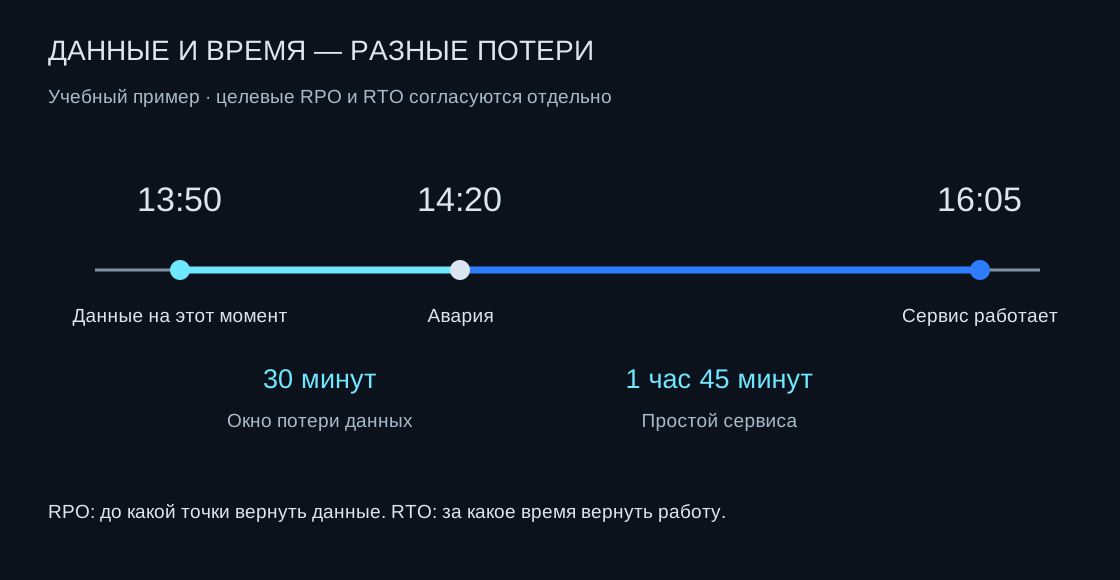
Учебный пример backupme. Потерянное окно данных — 30 минут, простой — 1 час 45 минут. Целевые RPO и RTO задаются отдельно.
Цель и результат теста нужно записывать отдельно
RPO и RTO — требования. Последняя успешная копия и длительность конкретного восстановления — наблюдаемые результаты. Не стоит подменять одно другим: тест на маленькой базе не устанавливает RTO для полной базы автоматически.
Показатель |
Согласованная цель в примере |
Измеренный результат |
Вывод |
|---|---|---|---|
RPO |
Не более 15 минут |
Потерянное окно 30 минут |
Требование не выполнено |
RTO |
Не более 2 часов |
Сервис вернулся за 1 час 45 минут |
В этом сценарии цель выполнена |
Обе оценки относятся к определённому сценарию. Потеря одной машины и недоступность всей площадки могут потребовать разных способов восстановления. Это нужно отметить до испытания, иначе две команды будут считать успешными разные результаты.
Почему расписание копирования ещё не гарантирует RPO
Задание может запускаться каждые 15 минут, но последние три запуска завершились ошибкой. Тогда доступная точка старше расписания. Другой вариант: локальные копии свежие, а передача на другую площадку отстаёт на два часа. При потере локального хранилища рассчитывать придётся на удалённую точку.
Значение имеет момент состояния данных, который представляет пригодная копия. Он может отличаться от времени завершения задания. Укажите его в отчёте и проверьте, нет ли пропуска в цепочке нужных версий или журналов.
Чтобы уменьшить окно потери, иногда достаточно чаще копировать небольшой набор. Для активно меняющейся базы может понадобиться другой механизм, например сохранение журналов транзакций. Это выбирают под конкретное приложение: простое копирование его открытых файлов не подтверждает согласованность данных.
Из чего складывается время возвращения сервиса
Время тратится на обнаружение остановки, решение о восстановлении, получение доступов, подготовку среды, возврат данных и проверку работы. Для своего регламента зафиксируйте начало отсчёта и критерий завершения. Если бизнес считает простой с момента отказа, отчёт только о времени копирования файлов его не устраивает.
В следующем учебном расчёте команда потратила 15 минут на обнаружение и решение, 20 минут на подготовку, 50 минут на данные и ещё 20 на проверку. Итого — 105 минут, то есть 1 час 45 минут. Ускорение передачи файлов на десять минут улучшит результат, но не устранит ожидание доступа к резервному хранилищу.
Полезно отдельно оценить нижнюю границу передачи. Для 500 ГБ по каналу 100 Мбит/с получается примерно 11,1 часа: 500 × 8 / 0,1 = 40 000 секунд. Здесь использованы десятичные единицы и идеальная непрерывная передача. Накладные расходы, ограничения сервиса, распаковка и запуск приложения увеличат срок. Значит, полное скачивание такого объёма по этому каналу не помещается в RTO два часа.
Как согласовать цели с владельцем процесса
Начните с одной функции, например отгрузки. Уточните, сколько последних изменений можно восстановить из других источников, сколько продлится ручной режим и когда остановка станет неприемлемой. Затем перечислите зависимости: база, каталог товаров, складская система, доступы, сеть.
Не назначайте одинаковые значения всему подряд. Для учебного обсуждения можно взять такие варианты:
Набор данных или сервис |
RPO для обсуждения |
RTO для обсуждения |
Что проверить |
|---|---|---|---|
Приём заказов |
15 минут |
2 часа |
Потерянные заказы и повторные оплаты |
Рабочие документы |
1 рабочий день |
1 рабочий день |
Возможность повторить изменения |
Старый фотоархив |
После каждой загрузки |
3 дня |
Сохранность новых оригиналов |
Это примеры для разговора, не отраслевые нормативы. У конкретной компании значения могут быть другими. Если технически цель пока недостижима, зафиксируйте разрыв и выберите действие: изменить архитектуру, выделить бюджет или согласовать временный ручной процесс.
Как провести первое измерение
Выберите сервис и сценарий отказа. Подготовьте изолированную среду без отправки реальных писем, списаний и изменений в рабочих системах. Восстановите данные, верните зависимости и выполните контрольную операцию. Фиксируйте время каждого этапа, точку возвращённых данных и задержки.
Если вы заранее подготовили сервер и исключили получение доступов, укажите эти условия: измерение описывает именно подготовленное восстановление. Для полного сценария потери площадки понадобятся дополнительные этапы. Закончите тест решением о том, что устранить и когда повторить проверку.
Следующий шаг: заполните паспорт восстановления, сверьте расположение копий по 3–2–1 и пройдите чек-лист. Термины собраны в глоссарии.
Источники
Дата сверки источников: 16 ноября 2026 года. Все числовые сценарии — учебные расчёты backupme.